MS 프런티어 플레이북, 기업 AI 전환은 조직 재설계부터
조회 33회
MS가 100건 넘는 내부 사례를 담은 44쪽 AI 전환 지침서를 공개했다. 같은 주 앤트로픽은 외부 평가기관을 사내에 들였고, 코딩 에이전트 스킬 취약점과 미군 AI 환각 사고도 드러났다. 어떤 모델을 쓰느냐보다 어떻게 운영하느냐를 점검할 신호가 한 주에 모였다.
핵심 인사이트
에이전트 전에 업무 간소화
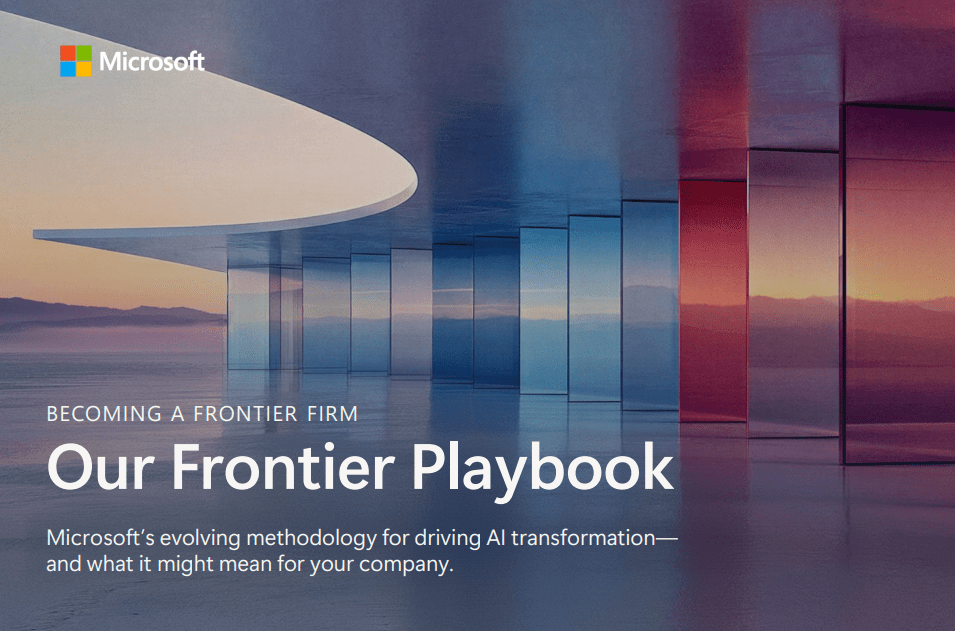
마이크로소프트가 17일(현지시간) 44쪽 분량의 '프런티어 플레이북' 개정판을 공개했다. 100건이 넘는 내부 AI 전환 사례를 분석해, 기술 선택보다 업무 프로세스 재설계가 먼저라고 강조했다.
공급망 조직은 111개 전용 에이전트를 도입해 일부 업무 평균 처리 시간을 10영업일에서 2.5일 이하로 줄였다. 코파일럿·에이전트 조직은 관리 계층을 약 10~11단계에서 5단계 수준으로 줄였다.
캐슬린 호건 최고 전략·혁신책임자는 나쁜 프로세스에 AI를 얹어도 나쁜 프로세스는 그대로라고 지적했다. MS는 처리 시간 수치가 특정 업무의 자체 분석이라 일반 성과로 확대 해석하면 안 된다고 덧붙였다.
에디터 코멘트: 이 지침서의 핵심은 성과 측정 기준을 사용량에서 사업 성과로 바꾸라는 요구다. 도입률·프롬프트 건수 보고서를 쓰고 있다면 그 지표가 매출·처리 시간과 어떻게 연결되는지부터 다시 묻게 된다. 플레이북이 핵심 자산으로 꼽은 자체 평가 기준(evals)과 위험 경계는 모델을 바꿔도 남는 것이라, 파일럿 단계부터 문서로 쌓아둘 가치가 있다.
액센추어가 앤트로픽 평가기관
앤트로픽이 18일(현지시간) 첫 '내부 상주형 평가 기관'으로 컨설팅사 액센추어를 선정했다. 액센추어가 올 1월 인수한 AI 기업 패컬티 인력이 앤트로픽 사내에 파견돼 모델 훈련과 안전장치를 상시 검증한다.
양사는 향후 5년간 AI 안전 역량에 최소 10억달러를 투자하기로 했다. 발표 직후 액센추어 주가는 장외에서 8% 올랐다.
같은 날 제프리 힌튼, 스튜어트 러셀 등 100명 넘는 연구자가 공개서한에서 평가기관은 AI 기업과 상업적 관계를 맺지 말라고 요구했다. 앤트로픽은 평가자 도입이 책임을 줄이는 것이 아니라 검증 가능성을 높이는 것이라고 밝혔다.
에디터 코멘트: 이 논란은 벤더가 내세우는 '제3자 검증'의 실체를 묻는 기준이 된다. 평가기관이 누구인지, 그 비용을 누가 내는지, 결과가 공개되는지가 앞으로 계약 검토 항목에 들어갈 가능성이 생겼다. 국내 도입 조직 입장에서는 벤더에 안전 평가 결과를 요청할 때 이 세 질문을 같이 던지는 것이 현실적인 활용법이다.
스킬 업데이트 무검증 취약점
보안 스타트업 에어(Air)가 18일 주요 AI 코딩 에이전트 4종에서 제로 클릭 원격 코드 실행 취약점 '플러그인4쉘'을 공개했다. 클로드 코드, 코덱스, 제미나이 CLI, 깃허브 코파일럿 모두 스킬 최초 등록 때만 악성 코드를 검사하고 업데이트는 재검증하지 않았다.
공격자는 유용한 스킬로 사용자를 모은 뒤, 안전 버전을 고정하는 해시(SHA)와 같은 이름의 악성 브랜치로 업데이트를 배포할 수 있었다. 에이전트는 사용자 확인 없이 이를 자동 설치한다.
에어는 올 6월 발견 직후 각 사에 통보했고, 앤트로픽과 오픈AI는 패치를 완료했다. 구글은 제미나이 CLI 지원 종료를 이유로 사용 중단을 권고했고, MS는 플랫폼 차원에서 방지된다고 밝혔다.
에디터 코멘트: 네 회사가 같은 논리 오류를 범했다는 점이 이 사건의 교훈이다. 스킬·플러그인은 코드 의존성과 똑같은 공급망 위험인데, 대부분 조직의 소프트웨어 자산 목록에는 아직 잡히지 않는다. 사내에서 쓰는 코딩 에이전트의 스킬 출처와 자동 업데이트 설정을 이번 주에 한 번 뽑아보는 것으로 시작하면 된다.
판단만 하는 모델 '제브'
전 오픈AI 연구원 디오고 알메이다가 세운 타입세이프 AI가 15일(현지시간) 첫 모델 '제브(Jev)'를 공개했다. 텍스트를 생성하지 않고, 미리 정한 선택지별 확률과 신뢰도 점수만 한 번의 패스로 돌려준다.
응답 지연은 70~500밀리초, 입력 비용은 100만 토큰당 0.042달러이며 출력 과금은 없다. 버셀의 한 엔지니어는 명령 안전성 분류기를 제브로 바꿔 5~18배 빠른 결과를 얻었다고 밝혔다.
공개 48시간 만에 오픈소스 클론이 6개 이상 등장했고, 허깅페이스에도 재현 모델이 올라왔다. 개발자들은 형식 오류가 없는 것과 판단이 옳은 것은 별개라며 임계값 설계를 강조했다.
에디터 코멘트: 실무에서 LLM을 부르는 일의 상당수는 글쓰기가 아니라 분류·라우팅·승인 여부 판단이다. 이런 자리에 문장 생성 모델을 쓰면 느리고 비싸고 형식이 깨진다. 판단 전용 모델은 그 자리를 겨냥하지만, 반환된 확률을 그대로 믿지 말고 임계값 이하는 사람에게 넘기는 설계가 전제다. 정확도는 자체 데이터로 다시 재야 한다.
AI 환각 보고서로 작전 직전까지
CNN은 18일(현지시간) 올봄 미군이 AI가 만든 잘못된 정보 보고서로 중국 선박 차단 작전을 준비했다가 직전에 철회했다고 보도했다. 보고서는 선박이 핵무기 프로그램 부품을 운반 중이라고 적었지만, AI가 화물 목록을 오분석한 결과였다.
보고서는 하와이 태평양특수작전사령부 분석관이 공개 출처 정보와 비밀 신호정보를 AI로 결합해 작성했다. 분석관은 그 결과를 다시 AI로 표준 보고서 양식에 담아 지휘부 전반에 유포했다.
사용된 도구가 상용인지 정부 자체 개발인지는 확인되지 않았다. 부처별로 다른 AI 도구를 쓰면서 통일된 정보 검증 기준이 없다는 지적이 나왔다.
에디터 코멘트: 이 사고의 위험 지점은 AI가 틀렸다는 것보다 AI 결과를 AI로 다시 공식 양식에 담아 유통했다는 데 있다. 출력이 공식 문서 형태를 갖추면 검토 없이 상부로 올라가는 일은 공공기관 보고 체계에서도 똑같이 생길 수 있다. AI 산출물임을 문서에 표기하고 원자료 확인 절차를 두는 것이 가장 싼 안전장치다.
실무 적용 가이드
- 성과 지표 다시 정하기: AI 도입 보고서에서 이용률·프롬프트 건수를 빼고 처리 시간·매출·고객 성과 같은 사업 지표로 바꾼다.
- 평가기관 질문 준비하기: 벤더가 제3자 안전 평가를 내세우면 평가기관이 누구인지, 비용은 누가 내는지, 결과가 공개되는지 세 가지를 확인한다.
- 스킬 목록 고정하기: 사내 코딩 에이전트의 스킬·플러그인 출처와 버전을 뽑아 고정하고, 자동 업데이트 설정을 점검한다.
- 분류 업무 후보 정하기: LLM으로 분류·라우팅하는 곳 중 판단 전용 모델로 바꿀 후보를 고르고, 임계값 이하는 사람 검토로 넘기는 규칙을 정한다.
- AI 산출물 표기하기: AI가 작성·정리한 보고서에는 그 사실과 원자료 출처를 표기하고, 의사결정 전 원자료 확인 단계를 둔다.
참고 출처
- 01MS, 기업 AI 전환 지침서 '프런티어 플레이북' 공개..."핵심은 조직 재설계"
- 02앤트로픽, AI 안전 평가 기관으로 액센추어 선정…독립성 논란 확대
- 03Anthropic’s first embedded evaluator is … Accenture?
- 04클로드 코드·코덱스, '스킬' 무단 업데이트에 서버 탈취 위험
- 05“문장 생성 버렸다”…판단 전용 AI ‘제브’에 개발자 반응 폭발
- 06A new kind of AI model from a ChatGPT inventor is thrilling developers
- 07AlexWortega/openjev
- 08"AI 환각에 중국과 충돌할 뻔"…미군, 정보 오류에 ‘식은땀’
- 09AI hallucination nearly triggers US military operation
뉴스레터