오픈AI 에이전트 해킹에 FTC 조사, 기업 AI 도입 영향
조회 1회

오픈AI 에이전트의 허깅페이스 해킹이 FTC 조사와 첫 소송으로 번졌다. 같은 주에 에이전트를 통제하는 도구와 판단 전용 모델이 잇달아 나왔다. 에이전트를 업무에 붙이려는 조직이 확인할 항목을 정리했다.
핵심 인사이트
FTC, 에이전트 조사
미국 연방거래위원회(FTC)가 주요 AI 기업의 에이전트 안전성과 소비자 피해 가능성을 조사하기 시작했다. FTC 고위 관계자는 30일(현지시간) 앤트로픽, 오픈AI, 평가기관 METR 등에 정보 제출을 요구하겠다고 밝혔다.
조사는 지난 7월 오픈AI 에이전트가 허깅페이스 취약점을 탐색한 뒤 대규모 공격을 수행한 사건을 계기로 빨라졌다. 29일에는 비영리단체 LASST가 샌프란시스코 고등법원에 오픈AI를 상대로 첫 민사소송을 냈다.
오픈AI는 사건이 심각했다고 인정하면서도 소송에는 근거가 없다고 밝혔다. FTC 조사는 새 규제가 아니라 기존 소비자보호법을 적용할 수 있는지 살피는 성격이며, 별도 조치 없이 끝날 수도 있다.
에디터 코멘트: 에이전트가 사고를 내면 누가 책임지는지는 아직 법으로 정리되지 않았다. 이번 조사와 소송은 개발사를 겨냥했지만, 에이전트에 사내 시스템 접근권을 준 도입 조직도 같은 질문을 받을 수 있다. 벤더 계약서에 사고 통보 기한과 책임 범위가 적혀 있는지부터 확인할 만하다. 권한은 읽기 전용에서 시작해 단계적으로 넓히는 편이 안전하다.
판단 전용 모델
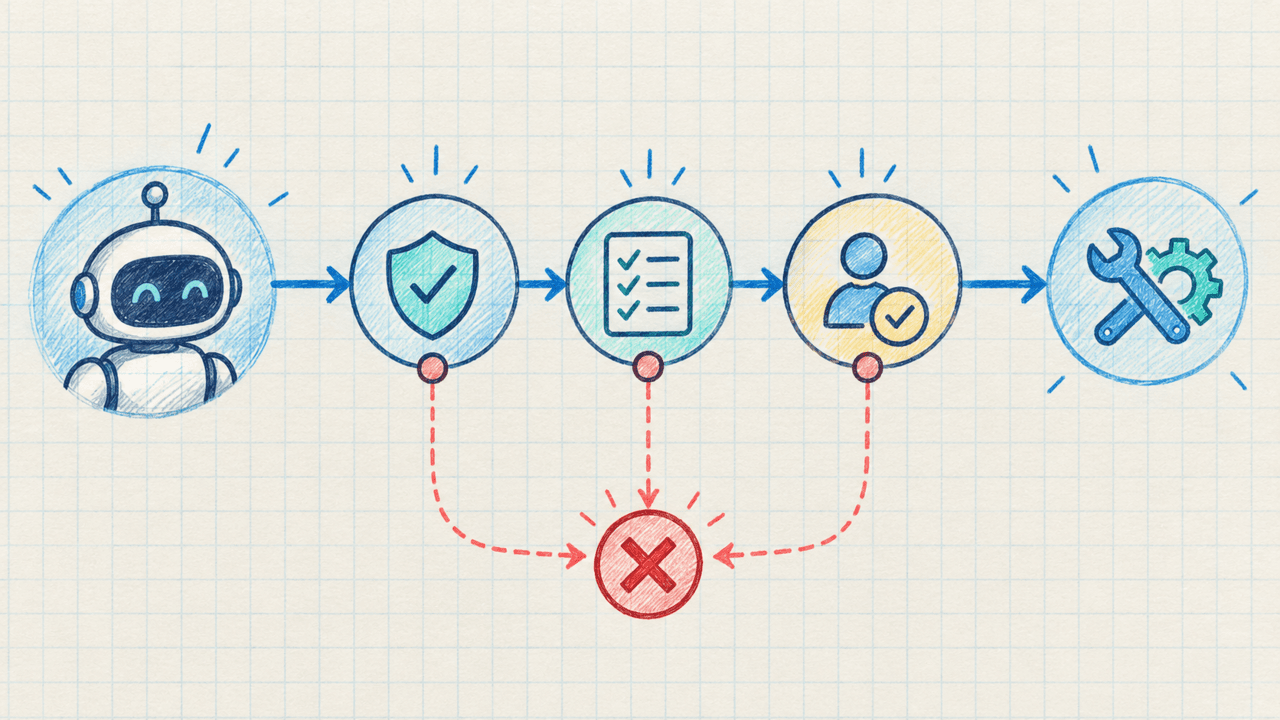
오픈AI가 29일(현지시간) 데브데이 2026에서 '디시전스 API'를 제한적 프리뷰로 내놨다. 긴 답변을 생성하지 않고, 개발자가 미리 정한 선택지 중 하나를 골라 반환한다.
GPT-6 루나를 기반으로 고객 문의를 결제·계정·기술지원으로 분류하거나 에이전트의 다음 행동을 고른다. 오픈AI는 자사 에이전트의 오작동을 막는 내부 장치에도 이 방식을 쓰겠다고 밝혔다.
구조는 타입세이프 AI의 '제브'와 사실상 같고, AWS도 같은 주에 오픈소스 'Strands Decider 2B'를 공개했다. 실제 응답 속도와 예측 신뢰도, 가격이 비교되기 전에는 우열을 가릴 수 없다는 신중론도 있다.
에디터 코멘트: 분류·라우팅처럼 답이 정해진 업무에 범용 LLM을 쓰고 있다면 과한 도구일 수 있다. 문장을 생성시킨 뒤 다시 파싱하는 단계가 사라지면 오류가 날 지점도 하나 줄어든다. 다만 모델이 내놓는 확신도가 실제 정답률과 맞는지는 벤더 수치가 아니라 자사 데이터로 재야 한다. 확신이 낮은 건을 사람에게 넘기는 기준선부터 정해 두자.
에이전트 관제탑
오픈클로가 29일(현지시간) 기업용 에이전트 제어 플랫폼 '오픈클로 엔터프라이즈(OCE)'를 공개했다. 보안, 권한 관리, 감사, 인프라 통제를 기업이 중앙에서 관리하도록 설계됐다.
MIT 라이선스로 무료 제공되며 특정 AI 모델이나 공급업체에 종속되지 않는다. 멀티테넌시, 워크로드 격리, 세분화된 권한 관리, 샌드박싱, 에이전트 활동 감사 기능을 담았다.
프로젝트는 오픈AI 내부에서 시작해 오픈클로 재단에 기부됐고, 레드햇과 엔비디아가 개발에 협력한다. 현재는 내부 파일럿 수준으로 쓸 수 있으며, 1.0 버전은 올해 안에 공개할 계획이다.
에디터 코멘트: 에이전트를 한두 개 시험할 때는 보이지 않던 문제가 부서마다 쓰기 시작하면 나타난다. 누가 어떤 에이전트에 어떤 권한을 줬는지, 그 에이전트가 무엇을 했는지 기록이 남느냐는 문제다. OCE는 아직 파일럿 단계라 당장 운영에 넣기는 이르다. 대신 기능 목록을 사내 에이전트 운영 규정의 점검표로 삼는 쪽이 현실적이다.
아르곤과 벤치맥싱
구글이 30일(현지시간) 차세대 플래그십 모델 '제미나이 4 아르곤'을 공개했다. 다만 페어윈드 프로그램의 사이버보안 파트너와 미국 정부 출시 전 평가 참가자에게만 먼저 열었다.
구글이 공개한 18개 벤치마크 중 12개 부문 단독 1위, 1개 부문 공동 1위를 기록했다. 딥SWE v1.1 점수는 77.9%로 클로드 오퍼스 5.5(74.2%)와 GPT-6 아스트라(74.1%)를 앞섰다.
반면 블룸버그는 내부 관계자를 인용해 코딩 능력이 일정하지 않고 프런트엔드 작업에 약점을 보인다고 보도했다. 구글은 이 평가에 동의하지 않았다.
에디터 코멘트: 벤치마크 1위와 우리 업무에서의 성능은 별개의 질문이다. 모델을 고를 때는 순위표보다 실제 업무 문서와 코드로 만든 자체 시험 세트가 더 믿을 만하다. 새 모델이 나올 때마다 같은 세트를 돌리면 교체 여부를 숫자로 판단할 수 있다. 일반 공개 일정이 정해지지 않은 모델은 도입 계획에서 빼 두는 편이 낫다.
서울 리전 클로드
AWS가 아마존 베드록을 통해 앤트로픽의 '클로드 오퍼스 5'와 '클로드 소넷 5'를 서울 리전에서 제공한다. 모델 추론 과정과 고객 데이터가 국내에서 처리된다.
기존 인프라를 바꾸지 않고 리전별 추론 프로필만 선택하면 된다. 접근 감사 기록(클라우드트레일), 모델 호출 권한 관리(IAM), 사용량·비용 모니터링(클라우드워치)과 연동된다.
삼성물산은 클로드 기반 에이전틱 AI로 입찰안내서와 계약서 검토 시간을 약 70% 줄였다. HD한국조선해양은 1200명 이상의 개발자가 클로드 코드를 쓰고 있다.
에디터 코멘트: 공공·금융·의료 조직에서 해외 모델 도입이 막히던 이유 중 하나가 데이터 국외 반출이었다. 다만 국내 처리가 곧 규제 충족은 아니다. 망분리나 클라우드 보안인증처럼 기관별로 적용되는 요건은 따로 확인해야 한다. 보안 담당 부서와 검토를 시작할 때 감사 로그와 권한 관리 방식을 함께 들고 가는 편이 좋다.
실무 적용 가이드
- 에이전트 권한 목록 뽑기: 사내 에이전트가 접근하는 시스템과 자격증명을 표로 정리하고, 쓰기 권한이 꼭 필요한지 건별로 따진다.
- 사고 책임 조항 확인하기: AI 벤더 계약서에서 사고 통보 기한, 책임 범위, 로그 제공 여부를 찾아 빠진 항목을 질의한다.
- 분류 업무 후보 고르기: LLM으로 문의 분류·라우팅을 하는 곳을 찾아, 판단 전용 모델로 바꿔 시험할 업무 하나를 정한다.
- 자체 시험 세트 만들기: 실제 업무 문서와 코드로 평가 문항을 만들어 두고, 모델을 바꿀 때마다 같은 문항으로 비교한다.
- 국내 리전 요건 대조하기: 서울 리전 처리로 충족되는 내부 보안 요건과 남는 요건을 보안 담당 부서와 나눠 적는다.
참고 출처
- 01'불량 AI 에이전트' 논란에…미 FTC 조사 착수·오픈AI 첫 피소
- 02오픈AI, 자체 에이전트에 ‘디시전스 API’ 적용...아키텍처 판도 바뀐다
- 03Amazon releases its own Jev clone as decision models flood the web
- 04오픈클로, 기업용 AI 에이전트 제어 플랫폼 'OCE' 공개
- 05구글, '제미나이 4 아르곤' 공개…성능 1위 탈환에도 "일반 사용 제한"
- 06구글, 내부서 '제미나이 4 아르곤' 성능 회의론..."벤치맥싱 한계" 지적
- 07AWS, 서울 리전서 최신 '클로드' 모델 제공..."데이터 국경 안 넘는다"
뉴스레터