메타 뮤즈 원더 출시, 채용·교육 AI 활용역량 평가 확산
조회 5회

메타가 첫 프런티어 모델 뮤즈 원더를 내놓고, 국내에선 16개 기업·기관이 채용·교육에 AI 역량평가를 들였다. 모델은 빨라지고 사람을 재는 잣대도 바뀌는 중이다. MS 사장의 규제 의무화 요구, 아멕스의 에이전트 결제 통제도 함께 본다.
핵심 인사이트
메타 뮤즈 원더는 어떤 모델인가?
메타가 12일 첫 프런티어 모델 '뮤즈 원더'와 상위 모델 '뮤즈 원더 풀'을 공개했다. 알렉산드르 왕이 이끄는 MSL이 AI 조직을 개편한 지 14개월 만에 내놓은 자체 최고 모델이다.
API 가격은 100만 토큰당 입력 4달러, 출력 20달러로 오퍼스 5.5와 같다. 독립 평가 아티피셜 애널리시스 지능 지수에서 원더 풀은 56점, 원더는 52점으로 오퍼스 5.5의 58점에는 못 미쳤다.
원더 풀은 월 50달러 또는 200달러의 '뮤즈 코드' 구독자에게만 제공되고 공개 API로는 쓸 수 없다. 메타는 긴 대화에서 사용자 정보를 유지하는 '액티브 메모리'를 핵심 특징으로 내세웠다.
에디터 코멘트: 모델 단가가 같아졌으니 이제 비교 기준은 가격표가 아니라 작업당 비용과 접근 경로다. 최상위 모델을 코딩 도구 구독에 묶는 방식은 기업이 API로 자동화 시스템에 붙일 수 없다는 뜻이다. 벤더를 고를 때 'API 제공 여부'와 '데이터 보존 조건'을 벤치마크 점수보다 먼저 확인할 때다.
AI 역량평가는 무엇을 재나?
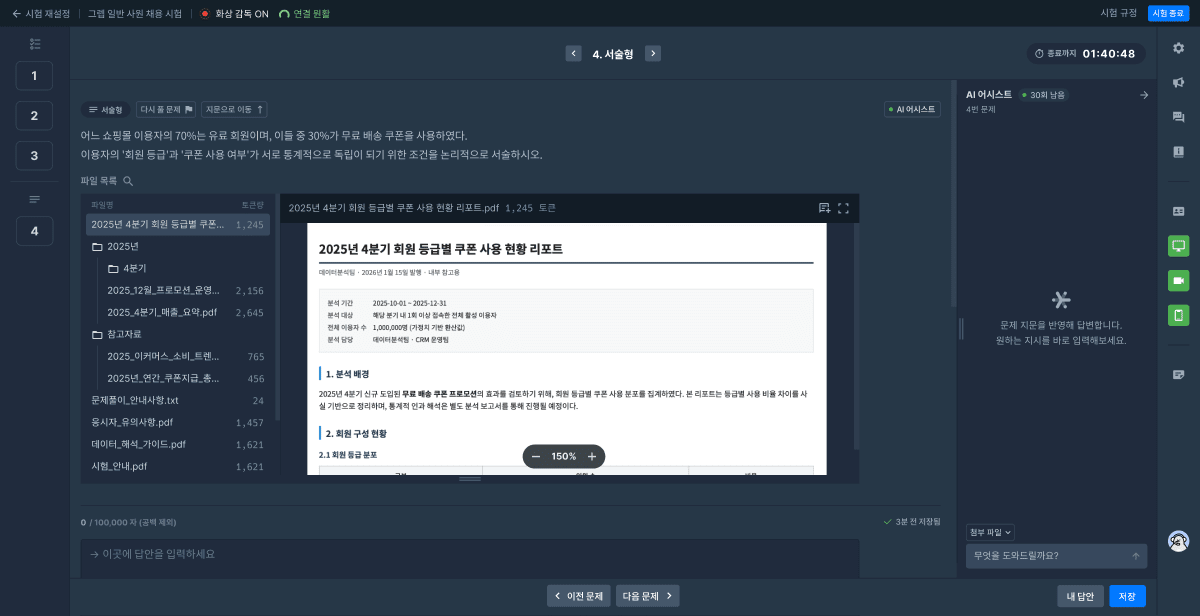
AI 온라인 평가 기업 그렙이 '프로그래머스 AI 역량평가' 도입 현황을 12일 공개했다. 지난 3월 출시 뒤 우리카드·국민대 등 16개 기업·기관이 들여왔고, 누적 응시자는 연내 4만 명을 넘길 것으로 회사는 기대한다.
도입처는 대기업·중견기업이 약 70%, 대학이 25%, 공공기관이 뒤를 이었다. 활용 목적은 채용 전형이 50%로 가장 많았고 AI 경진대회·체험 행사, 임직원 역량 진단 순이었다.
주요 시중은행은 기존 PT 면접을 AI 역량평가로 대체하고 있다고 그렙은 설명했다. 일반 직무엔 문서 작성·자료 분석 과제를 주고, 응시자의 프롬프트 기록으로 풀이 과정 전체를 평가한다.
에디터 코멘트: 카르파시는 같은 날 최첨단 모델로 전문 작업을 하는 집단이 전 세계 0.2%, 2000만 명뿐이라고 추산했다. 격차가 벌어질수록 조직은 '쓸 줄 아는가'를 측정하려 든다. 교육 담당자라면 결과물이 아니라 프롬프트 과정을 보는 이 평가 방식을 사내 교육의 사후 측정에 그대로 빌려 쓸 수 있다.
MS가 요구한 AI 규제 세 가지는?
브래드 스미스 MS 사장이 12일 BBC 인터뷰에서 AI 안전 규제의 법적 의무화를 촉구했다. 지금은 세탁기와 슈퍼마켓 우유가 AI보다 더 많은 안전 규제를 받는다는 것이 그의 비유다.
그가 제시한 조치는 세 가지다. 악성 에이전트 공격이나 통제 이탈 시 피해자 통지 의무, 시스템을 즉시 멈추거나 늦추는 비상 제동 장치, 기업의 사고 보고서 제출 의무다.
지난달 백악관에서 오픈AI·앤트로픽·구글 등이 독립 감사인 평가에 서명한 문서에 대해선 "좋은 조치지만 충분하지 않다"고 했다. 자율 규제는 책임 있는 기업만 따른다며, 규제 주도국으로는 영국을 꼽았다.
에디터 코멘트: 사고 통지·비상 제동·사고 보고는 공공기관의 정보보호 규정에 이미 있는 틀이다. 법이 되기 전이라도 에이전트를 붙인 시스템에는 이 셋을 내부 규정으로 먼저 적어두는 편이 낫다. 벤더 계약서에 '통제 이탈 시 통지' 조항이 있는지 확인하는 것이 출발점이다.
에이전트 무단 결제, 아멕스 해법은?
아메리칸 익스프레스가 AI 에이전트의 무단 결제를 막는 '인텐트 인텔리전스 프레임워크'를 공개했다. 에이전트가 결제를 마치기 전에 고객의 구매 의도를 포착하고 인증하는 구조다.
'Create Intent API'가 가맹점·최대 예산 같은 조건을 담고, 고객이 본인 인증 뒤 서명하면 '의도 증명 토큰'이 만들어진다. 에이전트는 실제 카드번호 대신 이 토큰으로 받은 디지털 결제 자격증명으로 결제한다.
아멕스 조사에서 미국 소비자 66%가 1년 내 가격 비교에 에이전트를 쓸 것 같다고 답했다. 카카오도 13일 '카나나 스페이스'의 메시지 발송·결제 같은 민감한 행동은 이용자가 직접 승인해야 실행된다고 밝혔다.
에디터 코멘트: 에이전트에 결제·발송 권한을 줄 때 핵심은 모델을 믿는 게 아니라 '승인된 의도'를 토큰으로 묶는 것이다. 사내 결재·구매 시스템에 에이전트를 붙인다면 예산 상한과 거래처를 사람이 서명한 조건으로 고정하고, 에이전트는 그 범위 안에서만 움직이게 설계한다. 카드사 표준이 되기 전이라도 같은 원리는 지금 적용할 수 있다.
사카나 AI 검토는 오류를 잡나?
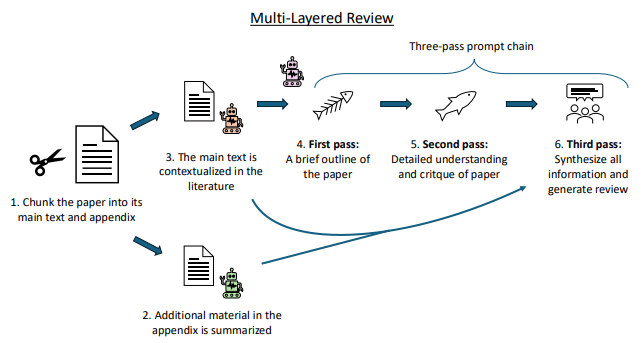
사카나 AI가 논문의 논리 오류를 찾아내는 LLM 동료 검토 시스템 'MLR'을 8일 공개했다. 심사자 의견을 흉내 내는 대신 실제 모순을 적발하는 능력을 측정한 것이 특징이다.
주요 학회 논문 257편에 삽입한 모순 1164개 중 핵심 주장 오류를 4회 검토 기준 73.43% 찾아냈다. 비교 대상 중 최고였던 에이전트리뷰의 14.81%보다 약 5배 높다.
다만 실제 철회 논문 211편에선 탐지율이 16.11%, 완화 기준으로도 26.07%에 그쳤다. 추가 학습 없이 상용 API 모델만 썼고, 선행 연구 검토를 뺀 심사 한 건 비용은 약 0.47달러다.
에디터 코멘트: 인위적 오류와 실제 오류의 탐지율 차이가 이 도구의 쓰임새를 정한다. 보고서·제안서의 숫자와 주장이 어긋나는지 1차로 걸러주는 용도로는 쓸 수 있지만, 통과했다고 검증이 끝난 것은 아니다. 내부 문서 검토에 LLM을 넣는다면 '모순 찾기' 질문으로 좁혀 쓰고 최종 판단은 사람이 한다.
실무 적용 가이드
- 벤더 접근 조건 표 만들기: 후보 모델마다 API 제공 여부·데이터 보존 기간·구독 전용 기능을 한 표에 적어 벤치마크 점수 옆에 둔다.
- 교육 효과를 과정으로 재기: 사내 AI 교육 뒤 결과물 대신 프롬프트 기록을 제출받아 풀이 과정을 평가 항목에 넣는다.
- 에이전트 사고 대응 규정 쓰기: 통제 이탈 시 통지 대상·중단 절차·보고 양식 세 가지를 정보보호 규정에 한 절로 추가한다.
- 결제 권한 범위 고정하기: 에이전트에 구매·송금을 맡기기 전에 예산 상한과 거래처를 사람이 승인한 목록으로 묶고 그 밖은 차단한다.
- 문서 검토 LLM 질문 좁히기: 보고서 검토에 LLM을 쓸 때 "요약해줘" 대신 "수치와 결론이 어긋나는 곳을 찾아라"로 지시한다.
참고 출처
- 01Meta releases its first frontier model, Muse Wonder
- 02메타, 자체 최고 모델 ‘뮤즈 원더’ 출시로 프런티어 경쟁 합류
- 03임직원 채용·교육에 'AI 활용역량 평가체계' 도입 확대
- 04카르파시가 진단한 AI 활용 격차..."날카로운 깔때기 형태로 벌어져"
- 05MS 사장 "세탁기·우유보다 못한 AI 규제…이제 법적 의무화 나설 때"
- 06Microsoft president says UK is best placed to drive AI regulation
- 07Amex introduces a framework to prevent AI agents from making unauthorized purchases
- 085000만 사용자 국민 메신저 카톡, AI 에이전트 허브로 진화 조준
- 09사카나 AI, LLM 기반 동료 검토 시스템으로 논문 핵심 주장 오류 73% 적발
뉴스레터